Couche 04 · Produit
MangaReader
Un lecteur de manga qui scrape des chapitres depuis des sites tiers, les fusionne en séries, et les sert via une interface web.
Ce que ça fait
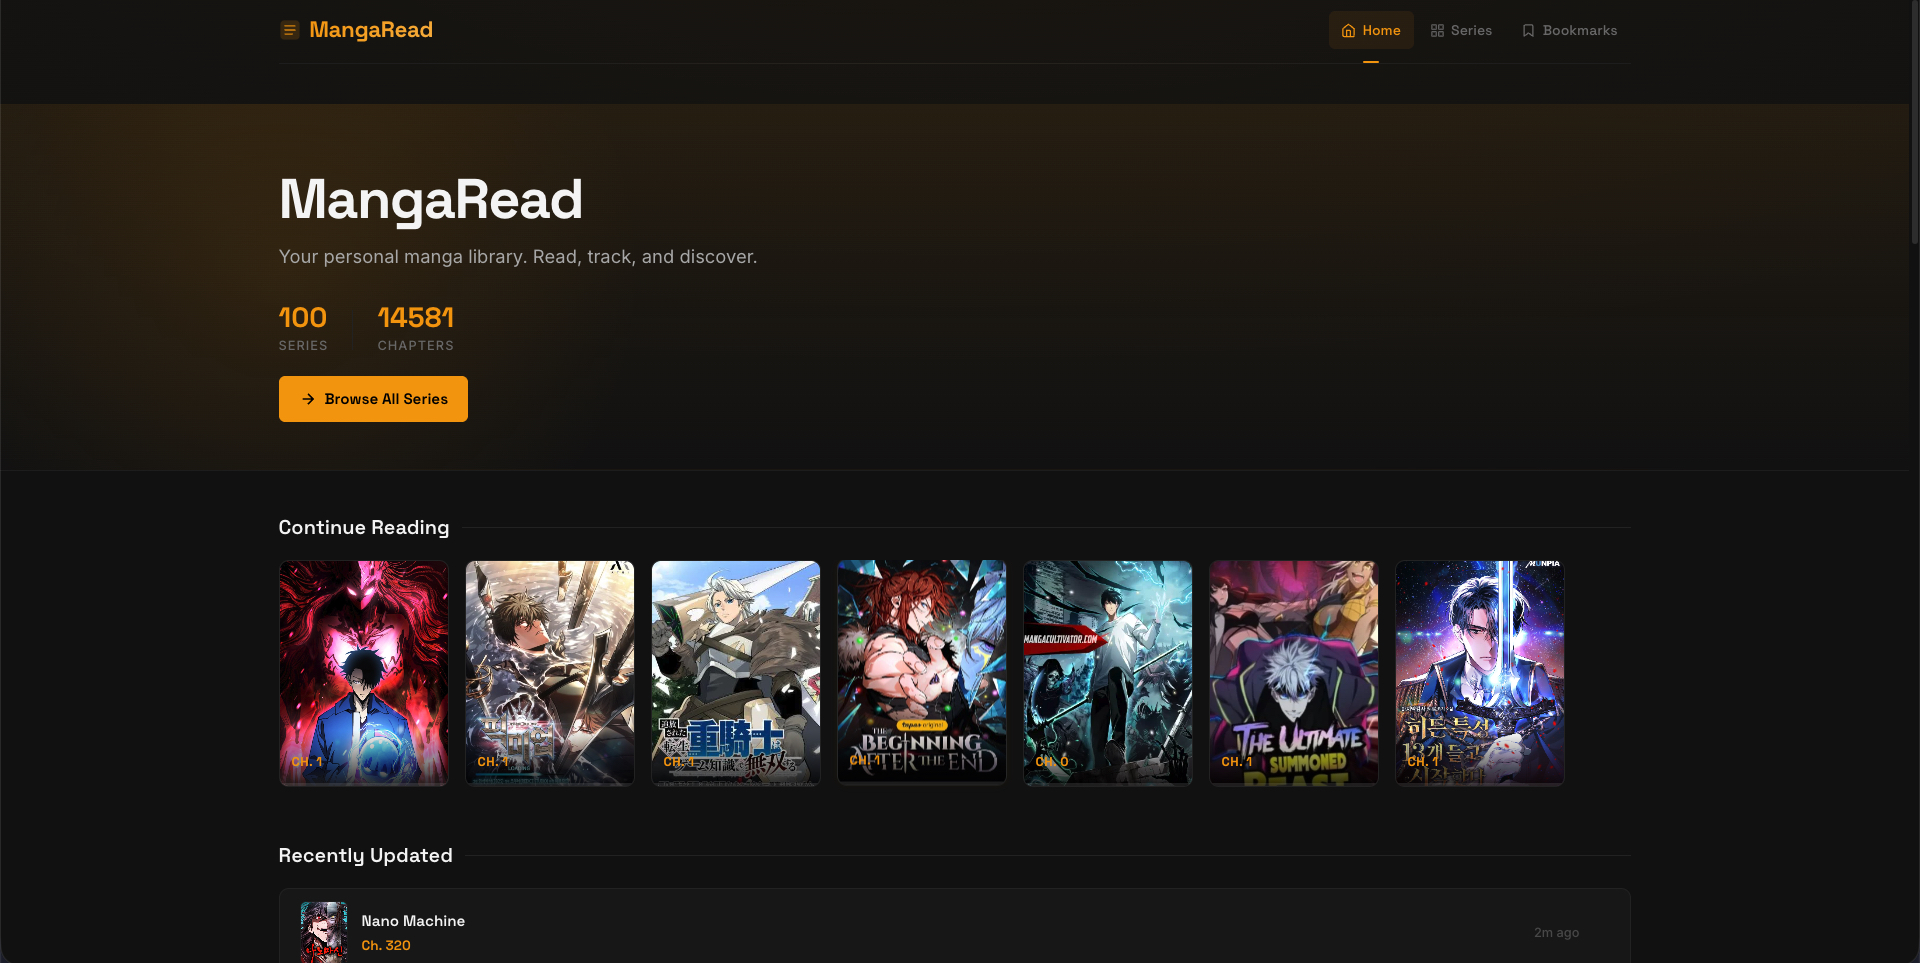
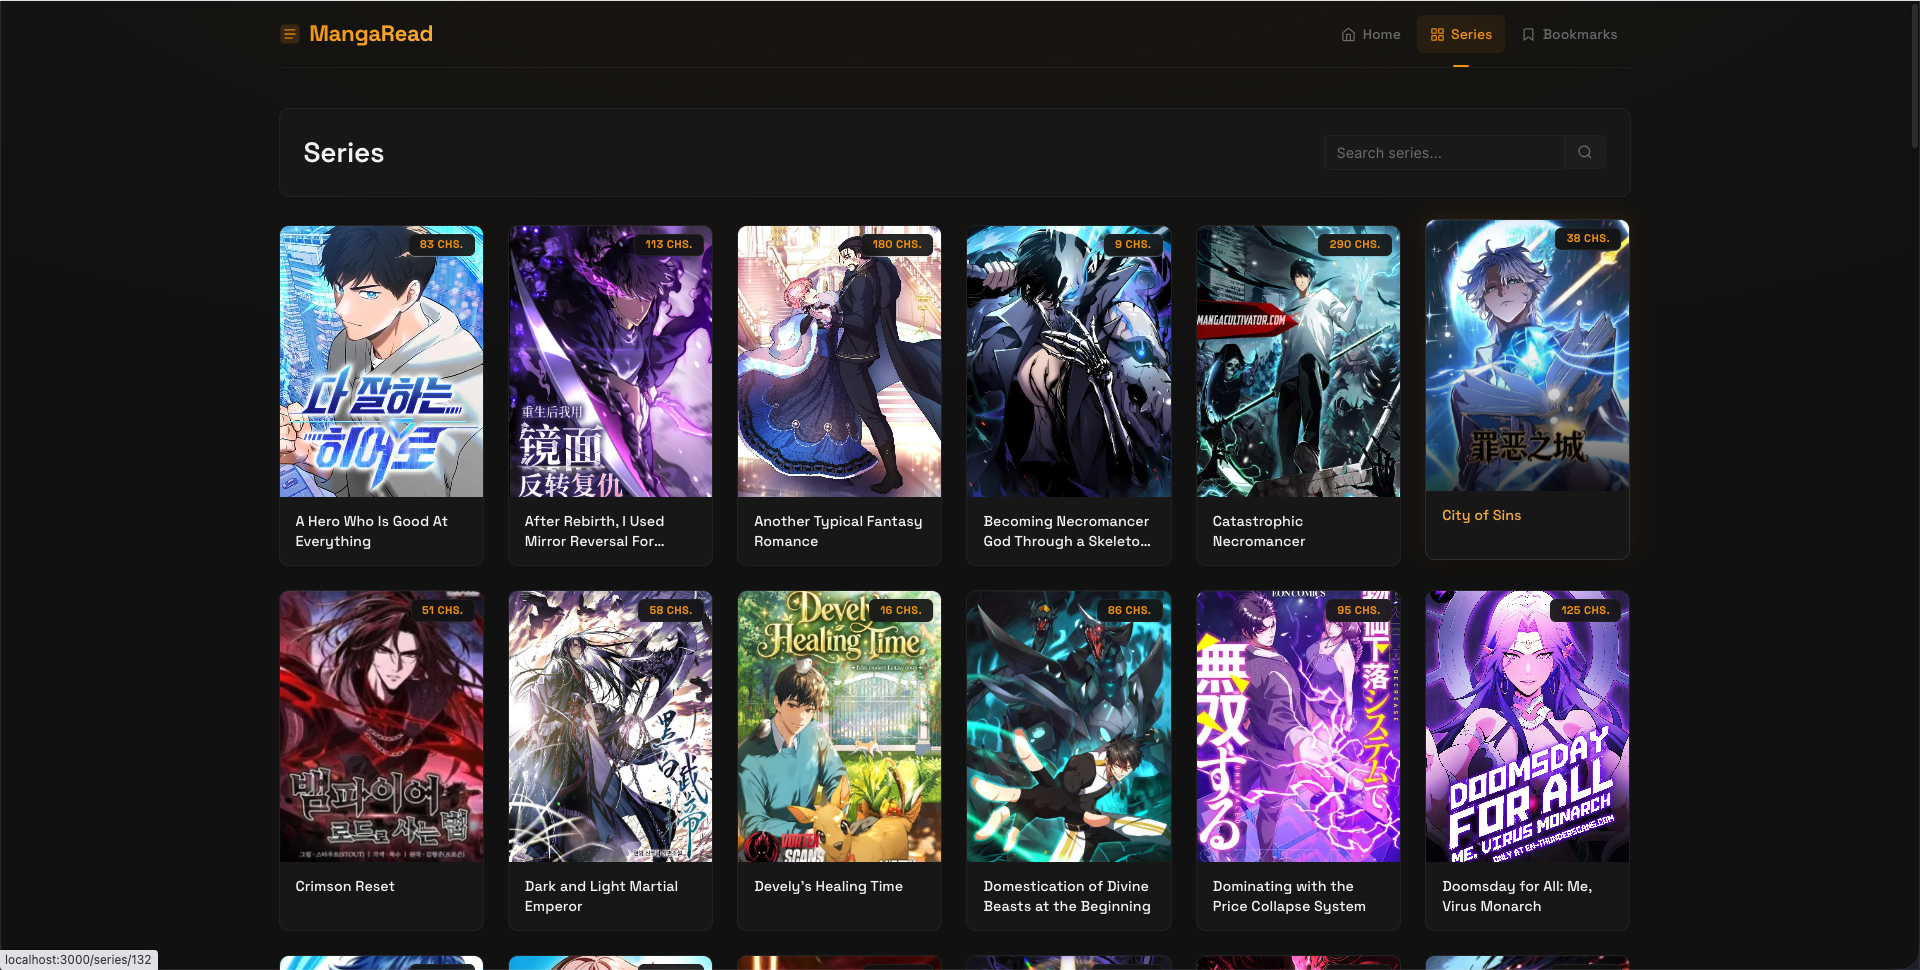
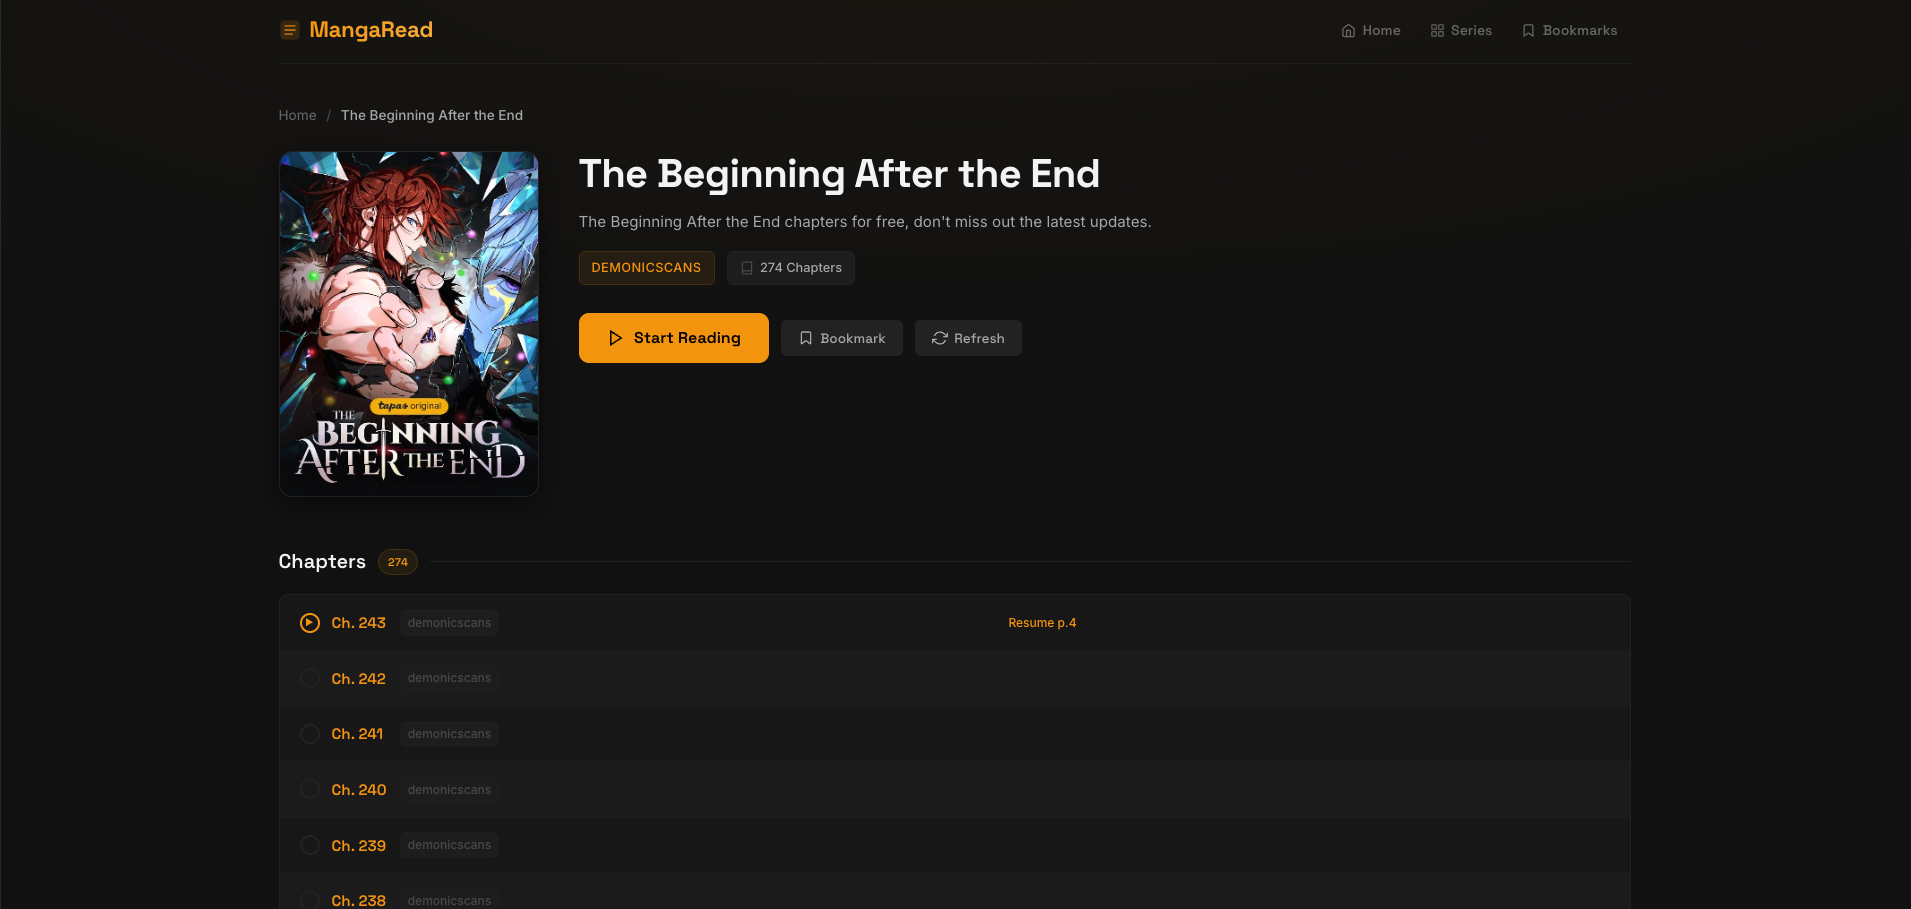
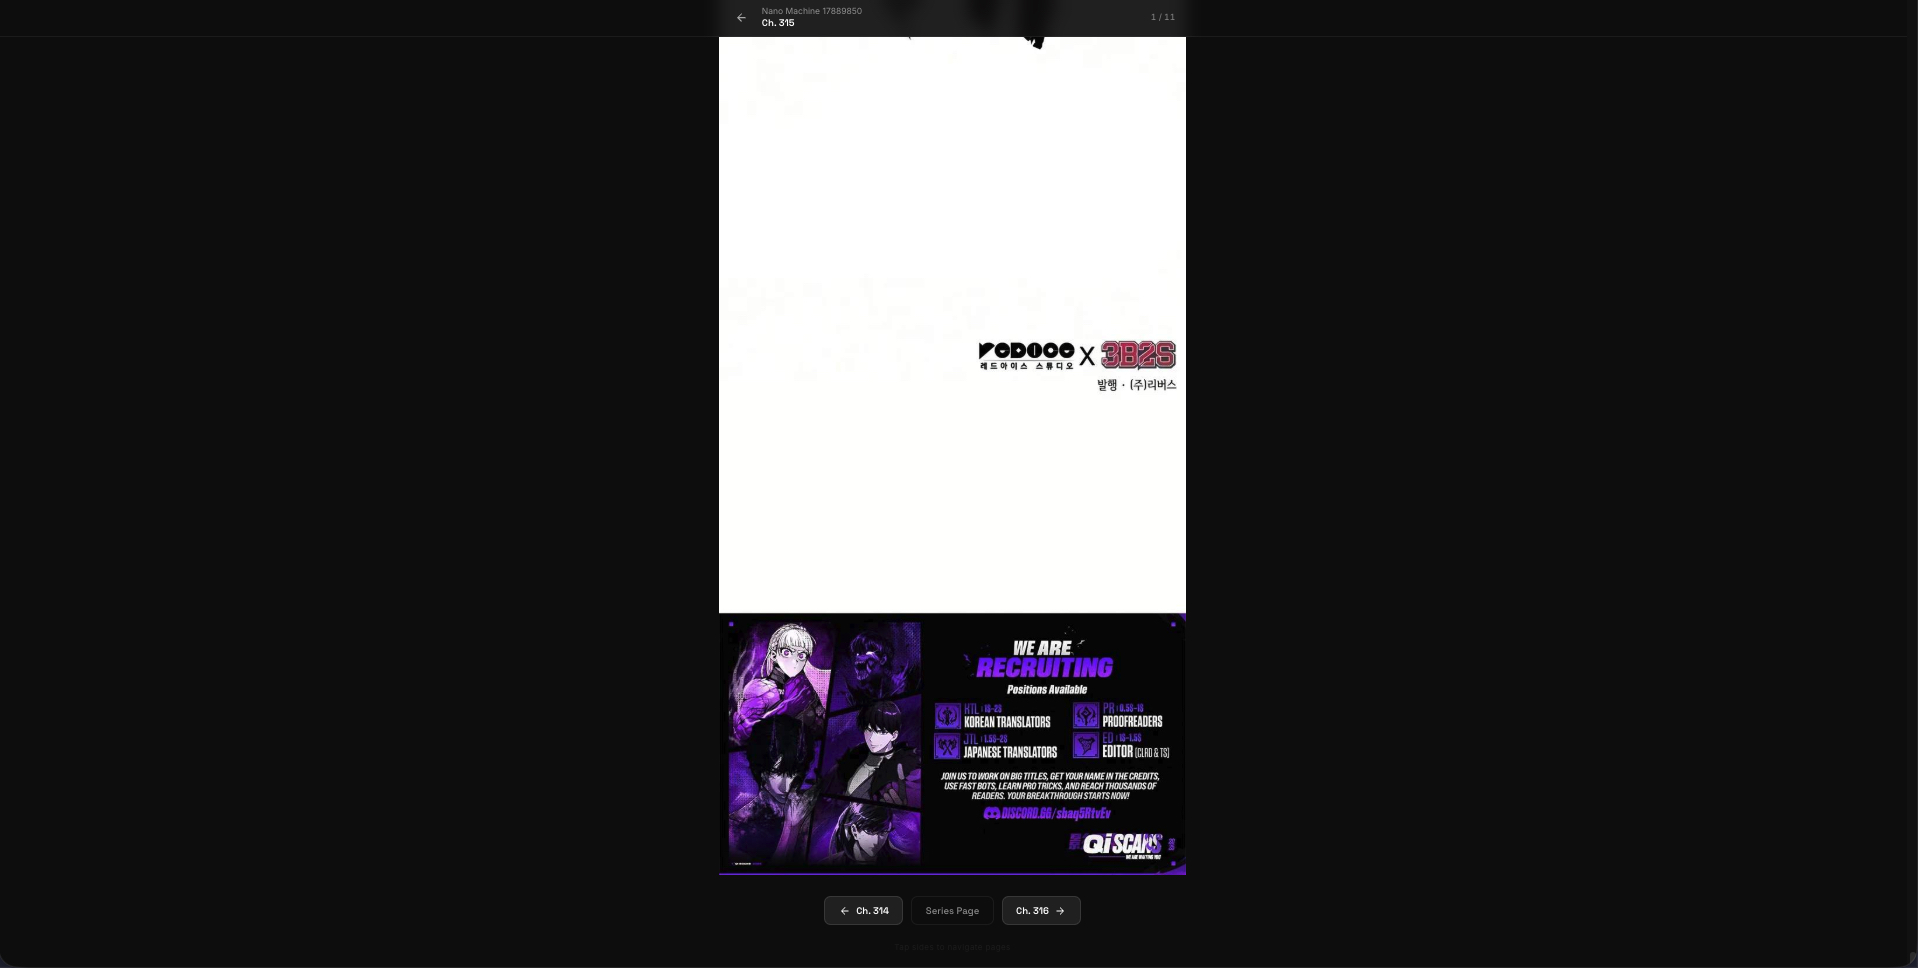
MangaReader est une bibliothèque de manga auto-hébergée. Elle récupère des chapitres sur des sites tiers, fusionne un même titre en une série, et sert un lecteur avec comptes, marque-pages et progression synchronisée. Les nouveaux chapitres se synchronisent en arrière-plan.
Architecture
Trois crates Rust dans un workspace :
- mangaread-core: types du domaine, repository SQLite, logique de fusion des séries
- scraper: trait SiteAdapter avec implémentations par site (Demonicscans, Manhuaplus), binaire CLI + bibliothèque
- website: serveur web Axum avec templates Maud, comptes, espace admin et assets statiques
La base de données utilise SQLite en mode WAL, dans un seul fichier.
flowchart TB
    CLI[ScraperEngine] --> DB[(SQLite)]
    WEB[Axum Server] --> DB
    WEB <--> BROWSER[Browser]
Comptes optionnels. Les visiteurs lisent sans se connecter et leur progression reste dans le navigateur. Les lecteurs connectés retrouvent progression, marque-pages et notes sur tous leurs appareils.
Captures d'écran
Les parties difficiles
Chromedriver. Le scraper utilise un vrai navigateur pour les sites manga chargés en JS. Faire marcher chromedriver dans Docker a pris 30% du temps de dev. Bugs de mode headless, problèmes de sandbox, processus zombies : le cirque habituel des webdrivers.
SQLite et le threading. La Connection de rusqlite n'est pas Sync, donc chaque thread de scraping ouvre sa propre connexion. Le AppState principal wrappe la sienne dans un Mutex. Ça semble simple, mais le borrow checker avait des opinions.
Se battre avec le borrow checker pour la 50ème fois à 2h du matin, c'est un rite de passage.
Ce que j'ai appris
Découper ce projet Rust en crates de workspace m'a plus appris que n'importe quel tutoriel. Le système de types de Rust est génial pour la modélisation du domaine (pas d'états invalides possibles), mais se battre avec le borrow checker pour la 50ème fois à 2h du matin, c'est un rite de passage.
Le pattern d'adaptateur (trait + implémentations par site) a payé immédiatement en ajoutant une deuxième source. Et la boucle de sync (thread background, intervalle de 6h, scraping parallèle) m'a appris les channels Tokio et l'arrêt gracieux à la dure.